Eine neue Aufgabe für unser Netz
In Teil 5 haben wir Gewichte und Bias-Werte trainiert. Unsere alte Aufgabe lautete: Ein Wort erfüllt das Ziel, wenn es mindestens fünf Zeichen hat und mit K beginnt. Nun ändern wir nur das Ziel: Genau eine der beiden Eigenschaften soll zutreffen.
Diese Verknüpfung heißt exklusives Oder, kurz XOR. Sie führt uns zu einer Frage: Was gewinnen wir durch eine verborgene Schicht und eine nichtlineare Aktivierungsfunktion? Wir vergleichen ein einfaches lineares Modell mit unserem Netz und rechnen beide in Python durch.
Praxistest: Der Artikel und das XOR-Experiment wurden in einer Linux-Mint-VM nachvollzogen und bestätigt.
Die vier möglichen Eingaben
Wie bisher ist x1 gleich 1, wenn das Wort mindestens fünf Zeichen hat. x2 ist 1, wenn es mit einem großen K beginnt. Das Ziel ist diesmal 1, wenn genau eines der Merkmale 1 ist:
| Wort | x1: mindestens 5 Zeichen | x2: beginnt mit K | XOR-Ziel |
|---|---|---|---|
| Maus | 0 | 0 | 0 |
| Elefant | 1 | 0 | 1 |
| Klee | 0 | 1 | 1 |
| Katze | 1 | 1 | 0 |
Die gleichen vier Merkmalskombinationen kennen wir aus den vorherigen Teilen. Die Zielwerte sind jetzt andere. Ein bereits trainiertes Netz aus Teil 5 hat deshalb nicht automatisch die richtige Aufgabe gelernt.
Warum eine einzelne Gerade nicht genügt
Stellen wir x1 und x2 als Koordinaten dar, liegen die beiden Punkte mit Zielwert 1 an gegenüberliegenden Ecken. Die Punkte mit Zielwert 0 liegen an den beiden anderen Ecken.
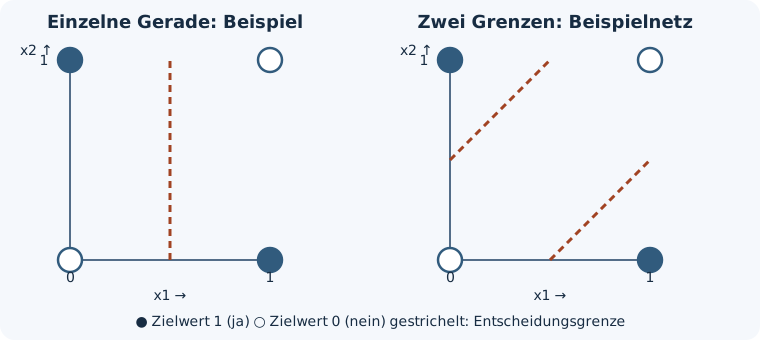
Links ist eine mögliche Gerade eingezeichnet. Sie ordnet nicht alle vier Punkte richtig zu. Das Problem liegt aber nicht nur an dieser einen Position: Keine einzelne Gerade kann die beiden 1-Punkte gemeinsam auf eine Seite und die beiden 0-Punkte auf die andere legen.
Das lässt sich auch ohne Zeichnung prüfen. Ein lineares Modell mit Bias hat die Form s = w1 × x1 + w2 × x2 + b. Wir wählen für die Klasse 1 die Grenze s >= 0,5. Wenn die beiden Punkte mit Zielwert 1 korrekt erkannt werden, müsste gelten:
(1, 0): w1 + b >= 0,5
(0, 1): w2 + b >= 0,5
Addieren wir beide Bedingungen, folgt w1 + w2 + 2b >= 1. Wenn dagegen beide Punkte mit Zielwert 0 korrekt erkannt werden, müsste gelten:
(0, 0): b < 0,5
(1, 1): w1 + w2 + b < 0,5
Zusammen folgt daraus w1 + w2 + 2b < 1. Beides kann nicht gleichzeitig stimmen. Das gilt entsprechend auch für eine andere feste Klassengrenze. Ein einzelnes lineares Modell kann diese XOR-Punkte also nicht vollständig mit einer geraden Grenze trennen.
Reichen einfach mehr Schichten?
Nicht unbedingt. Ohne eine nichtlineare Aktivierung lassen sich aufeinanderfolgende affine Rechnungen wieder zu einer einzigen affinen Rechnung zusammenfassen. Ein einfaches Beispiel mit nur einer Zahl:
Erste Schicht:   h = 2 × x + 1
Zweite Schicht:  y = 3 × h - 2
Zusammengefasst: y = 3 × (2 × x + 1) - 2 = 6 × x + 1
Die zusätzliche Schicht allein hat aus dieser Verkettung keine gekrümmte oder geknickte Funktion gemacht. Die gleiche Grundidee gilt auch für Vektoren und mehrere rein affine Schichten. In unserem Netz verwenden wir dagegen ReLU: ReLU(z) = max(0, z). Diese Funktion knickt bei 0 ab. Die verborgenen Neuronen können dadurch unterschiedliche Teilbereiche verarbeiten, deren Ausgaben die nächste Schicht kombiniert. Der Machine Learning Crash Course erklärt die Rolle von Aktivierungsfunktionen ausführlicher.
Mehr Schichten und Nichtlinearität garantieren trotzdem keinen Lernerfolg. Architektur, Startwerte, Daten, Fehlerfunktion und Training beeinflussen gemeinsam das Ergebnis.
Ein kleines Netz löst XOR von Hand
Wir verwenden wieder zwei verborgene Neuronen und ein Ausgabeneuron, diesmal mit anderen Parametern:
h1 = ReLU( x1 - x2)
h2 = ReLU(-x1 + x2)
y  = ReLU(h1 + h2)
Die Bias-Werte sind in diesem Beispiel alle 0. Ausgegeben wird die Klasse 1 bei y >= 0,5, sonst 0. Für die vier Eingaben ergibt sich:
| Eingabe | h1 | h2 | Ausgabe y | Klasse |
|---|---|---|---|---|
| (0, 0) | 0 | 0 | 0 | 0 |
| (1, 0) | 1 | 0 | 1 | 1 |
| (0, 1) | 0 | 1 | 1 | 1 |
| (1, 1) | 0 | 0 | 0 | 0 |
Für (1, 0) rechnet h1 also ReLU(1 - 0) = 1. Gleichzeitig rechnet h2 ReLU(-1 + 0) = 0. Das Ausgabeneuron erhält (1, 0) und liefert 1. Bei (1, 1) liefern beide verborgenen Neuronen 0.
Auf der rechten Seite des Diagramms sind die Entscheidungsgrenzen dieses von Hand festgelegten Beispielnetzes für Eingaben zwischen 0 und 1 eingezeichnet. Hier gilt y = |x1 - x2|. Die beiden gestrichelten Linien markieren |x1 - x2| = 0,5. Sie zeigen, wie mehrere Teilbereiche entstehen. Das ist nicht die Ausgabe eines Trainingslaufs.
Zwei Modelle selbst trainieren
Wir verwenden die Dateien neuron.py und trainieren.py aus den vorherigen Teilen. trainieren.py stellt unter anderem merkmale(), vorwaerts(), mittelwert_fehler() und trainingsschritt() bereit. Die gespeicherte Datei parameter.json aus Teil 5 bleibt unverändert. Für XOR beginnen wir mit eigenen, ausdrücklich festgelegten Startwerten.
Öffne ein Terminal in der Linux-VM und gehe in den Projektordner:
cd ~/eigene-kiFalls du die automatische Aktivierung nicht verwendest, aktiviere die Umgebung mit source .venv/bin/activate. Wir benötigen keine zusätzlichen Pakete. Erstelle eine neue Datei xor_vergleich.py:
from trainieren import merkmale, mittelwert_fehler, trainingsschritt, vorwaerts


DATEN = [("Maus", 0), ("Elefant", 1), ("Klee", 1), ("Katze", 0)]
LERNRATE = 0.1
SCHRITTE = 3000


def linear_vorhersage(x, parameter):
    return parameter[0] * x[0] + parameter[1] * x[1] + parameter[2]


def linear_fehler(daten, parameter):
    return sum((linear_vorhersage(merkmale(wort), parameter) - ziel) ** 2
               for wort, ziel in daten) / len(daten)


def linear_schritt(daten, parameter, lernrate):
    gradient = [0.0, 0.0, 0.0]
    for wort, ziel in daten:
        x1, x2 = merkmale(wort)
        differenz = linear_vorhersage((x1, x2), parameter) - ziel
        for i, eingabe in enumerate((x1, x2, 1)):
            gradient[i] += 2 * differenz * eingabe / len(daten)
    for i in range(3):
        parameter[i] -= lernrate * gradient[i]


def klasse(wert):
    return 1 if wert >= 0.5 else 0


def main():
    # Lineares Modell: w1, w2, Bias.
    linear = [0.0, 0.0, 0.0]
    # Das Netz hat dieselbe Struktur wie in Teil 5, aber andere Startwerte.
    netz = {"w": [[1.0, -1.0], [-1.0, 1.0]], "b": [-0.1, -0.1],
            "v": [0.6, 0.6], "c": 0.1}

    print(f"Startfehler linear: {linear_fehler(DATEN, linear):.6f}")
    print(f"Startfehler Netz:   {mittelwert_fehler(DATEN, netz):.6f}")
    for _ in range(SCHRITTE):
        linear_schritt(DATEN, linear, LERNRATE)
        trainingsschritt(DATEN, netz, LERNRATE)

    print(f"Endfehler linear: {linear_fehler(DATEN, linear):.6f}")
    print(f"Endfehler Netz:   {mittelwert_fehler(DATEN, netz):.6f}")
    print("Lineare Parameter (w1, w2, Bias):", [round(p, 4) for p in linear])
    print("Netzparameter:", netz)
    for wort, ziel in DATEN:
        x = merkmale(wort)
        l = linear_vorhersage(x, linear)
        n = vorwaerts(x, netz)[3]
        print(f"{wort}: x={x} Ziel={ziel} linear={l:.4f} "
              f"(Klasse {klasse(l)}) Netz={n:.4f} (Klasse {klasse(n)})")


if __name__ == "__main__":
    main()
Beide Modelle minimieren den mittleren quadratischen Fehler über dieselben vier Beispiele. Das lineare Modell hat zwei Gewichte und einen Bias. Das Netz besitzt sechs Gewichte und drei Bias-Werte. Die Parameter starten hier fest vorgegeben, nicht zufällig. Die feste Konfiguration ist bewusst so gewählt, dass die beiden verborgenen Neuronen zunächst unterschiedliche Richtungen erkennen. Andere Startwerte oder Lernraten können zu anderen Ergebnissen führen.
Starte den Vergleich:
python xor_vergleich.pyDas Programm zeigt Start- und Endfehler, die tatsächlich erreichten Parameter sowie Ausgaben und Klassen für alle vier Wörter. Ein Auszug aus einem lokalen Probelauf:
Startfehler linear: 0.500000
Startfehler Netz:   0.069800
Endfehler linear: 0.250000
Endfehler Netz:   0.000000
Lineare Parameter (w1, w2, Bias): [0.0, 0.0, 0.5]
Danach folgen die Netzparameter und die Ergebnisse für jedes Wort. Das Netz ordnete im Probelauf alle vier Beispiele richtig zu. Die Darstellung rundet die Ausgaben, und 0.000000 bedeutet nicht zwingend mathematisch exakt null.
Die linearen Ausgaben liegen nach diesem Lauf nahe 0,5. Bei einer Grenze von 0,5 können winzige Rundungsunterschiede beeinflussen, welche Klasse für diese Werte angezeigt wird. Die auf vier Stellen gerundete Anzeige allein reicht dafür nicht aus. Entscheidend ist: Eine einzelne Gerade kann die vier XOR-Punkte nicht alle korrekt trennen, unabhängig davon, wie wir sie einstellen.
Was sagt dieser Versuch über neue Daten?
Die vier Trainingspunkte decken alle möglichen Kombinationen dieser beiden binären Merkmale ab. Andere Wörter wie „Karte“ oder „Kuh“ ergeben wieder eine dieser vier Kombinationen. Das Netz kann Wörter mit gleichen Merkmalen nicht unterscheiden. Ein Test mit solchen anderen Wörtern ist nützlich, um die Merkmalsberechnung zu prüfen. Er belegt aber keine Generalisierung auf neue Informationen.
Überanpassung bedeutet, dass ein Modell Besonderheiten der Trainingsdaten übernimmt und auf geeigneten, zuvor nicht verwendeten Daten schlechter funktioniert. Mit nur diesen vier binären Punkten können wir das nicht sinnvoll nachweisen. Für einen aussagekräftigeren Versuch bräuchten wir eine andere Aufgabe mit vielfältigeren Eingaben, beispielsweise zusätzliche numerische Merkmale, sowie getrennte Trainings- und Testdaten. Die Testdaten dürften bei der Wahl und Anpassung des Modells nicht zum Training dienen.
Selbst ausprobieren
- Ändere in
DATENtestweise"Klee"zu"Kuh". Beide haben die Merkmale(0, 1). Das Ergebnis sollte sich dadurch nicht ändern. Stelle anschließend die ursprüngliche Liste wieder her. - Verringere
SCHRITTEauf1und vergleiche Start- und Endfehler beider Modelle. Setze danach3000wieder ein. - Ändere die Startwerte des Netzes oder die Lernrate und beobachte, ob das Training noch dieselben Fehler erreicht. Notiere deine Änderungen und stelle die ursprünglichen Werte anschließend wieder her.
Bei ModuleNotFoundError prüfe, ob neuron.py, trainieren.py und xor_vergleich.py im selben Projektordner liegen. Wenn der Netzfehler nicht wie beschrieben sinkt, kontrolliere Zielwerte, Startparameter, Lernrate und Schrittzahl. Die bisherige parameter.json wird von diesem Experiment weder gelesen noch geschrieben.
Wie geht es weiter?
Unser Beispiel zeigt, wie eine nichtlineare verborgene Schicht eine Aufgabe ermöglicht, die eine einzelne Gerade nicht löst. Im nächsten Teil schlagen wir die Brücke vom kleinen Wortklassifikator zum Sprachmodell: Was bleibt von Gewichten, Schichten und Training erhalten, und welche Bausteine kommen für Textfolgen hinzu?