Vom Regelprogramm zum Netz
Im ersten Teil haben wir Wörter anhand ihrer Länge mit einer festen Regel in „kurz“ und „lang“ eingeteilt. Nun bauen wir ein kleines neuronales Netz. Wieder geht es um Wörter. Diesmal entscheiden zwei Eigenschaften gemeinsam über die Ausgabe.
Das Netz besteht aus zwei Eingaben, zwei künstlichen Neuronen in einer verborgenen Schicht und einem Ausgabeneuron. Seine Gewichte legen wir zunächst selbst fest. Es lernt in diesem Teil noch nicht. Trotzdem können wir sehen, wie Zahlen über Verbindungen durch das Netz wandern und eine Ausgabe erzeugen. Dieses Lehrnetz werden wir in den folgenden Teilen weiter untersuchen. Das spätere Sprachmodell hat zusätzliche Bausteine und ist nicht dieses Netz in Groß.
Praxistest: Die Schritte und das Python-Beispiel dieses Artikels wurden in einer Linux-Mint-VM nachvollzogen und bestätigt.
Eine kleine Aufgabe mit zwei Merkmalen
Unser Netz soll für eine Zeichenfolge prüfen, ob beide Eigenschaften zutreffen:
- Sie hat mindestens fünf Zeichen.
- Sie beginnt mit einem großen
K.
Das ist eine künstliche Übungsaufgabe. Eine normale if-Abfrage wäre dafür einfacher. Uns interessiert aber der Aufbau des Netzes. Um aus Text Zahlen zu machen, berechnen wir zwei Merkmale: Für eine zutreffende Eigenschaft verwenden wir 1, sonst 0.
| Wort | x1: mindestens 5 Zeichen | x2: beginnt mit K | Gewünschte Klasse |
|---|---|---|---|
| Katze | 1 | 1 | ja |
| Klee | 0 | 1 | nein |
| Elefant | 1 | 0 | nein |
| Maus | 0 | 0 | nein |
Die gewünschten Klassen haben wir vorgegeben. Sie sind Zielwerte, keine vom Netz gelernten Erkenntnisse. Dass x1 und x2 genau diese Bedeutung haben, entscheiden wir beim Programmieren. Das Netz selbst bekommt nur die Zahlen. Eine Eingabe besteht hier also aus einem Zahlenpaar, zum Beispiel [1, 1] für „Katze“.
Was ist wo im Netz?
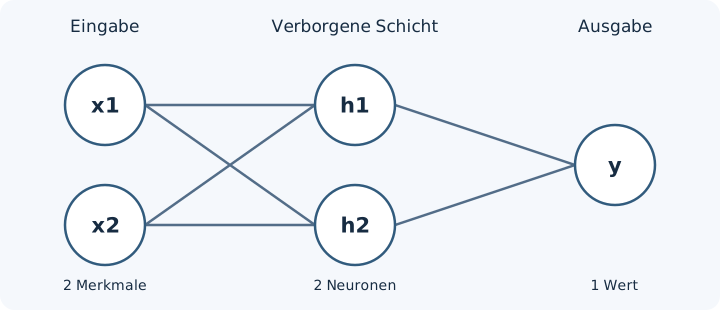
Die Kreise und Linien sind eine Darstellung von Berechnungen, keine biologischen Nervenzellen oder echten Drähte. Für unser Beispiel gilt:
- Eingabe:
x1undx2stehen für die beiden Merkmalswerte. Die Eingabeknoten stellen Werte bereit, sie berechnen hier selbst nichts. - Verborgene Schicht:
h1undh2erhalten jeweils beide Eingaben. Jedes dieser Neuronen berechnet daraus einen eigenen Wert. „Verborgen“ bedeutet: Diese Zwischenwerte werden in unseren Beispieldaten nicht als gewünschte Ausgabe vorgegeben. - Ausgabe:
ywird aush1undh2berechnet. Das Programm ordnet den Zahlenwert anschließend einer Klasse zu. - Verbindungen: Jede Linie steht in dieser Darstellung für ein Gewicht, also eine Zahl, mit der ein eingehender Wert bei der Berechnung berücksichtigt wird.
Wir haben vier Verbindungen von der Eingabe zur verborgenen Schicht und zwei von dort zur Ausgabe: insgesamt sechs Gewichte. Dazu kommen drei Bias-Werte, je einer pro berechnendem Neuron. Bias ist ein weiterer einstellbarer Zahlenwert. Zusammen sind das neun Parameter. Die zwei Eingabeknoten zählen wir dabei nicht als berechnende Neuronen.
Nicht jedes neuronale Netz sieht so aus. Hier ist jede Eingabe mit jedem Neuron der nächsten Schicht verbunden. Solche Schichten werden vollständig verbunden genannt. Andere Netzarchitekturen verbinden und verarbeiten Werte anders. Einen ausführlicheren Blick auf Knoten und verborgene Schichten bietet der Machine Learning Crash Course von Google.
Welche Zahlen stehen auf den Verbindungen?
Wir legen die Parameter für dieses Beispiel von Hand fest. Die Zeilen der ersten Tabelle gehören jeweils zu einem verborgenen Neuron:
| Neuron | Gewicht von x1 | Gewicht von x2 | Bias |
|---|---|---|---|
| h1 | 1 | 1 | -1 |
| h2 | 1 | 1 | 0 |
Für das Ausgabeneuron gelten Gewicht 1 von h1, Gewicht 0,5 von h2 und Bias 0. In Python schreiben wir Dezimalzahlen mit Punkt: 0.5.
Jedes Neuron addiert seine gewichteten Eingänge und den Bias. Danach verwenden wir hier die Aktivierungsfunktion ReLU: Negative Ergebnisse werden zu 0, positive bleiben unverändert. Für „Katze“ mit x1 = 1 und x2 = 1 ergibt sich:
h1 = ReLU(1 × 1 + 1 × 1 - 1) = ReLU(1) = 1
h2 = ReLU(1 × 1 + 1 × 1 + 0) = ReLU(2) = 2
y  = ReLU(1 × h1 + 0,5 × h2 + 0) = ReLU(2) = 2
Die drei Zeilen zeigen den Vorwärtsdurchlauf für genau eine Eingabe. h1 und h2 sind Zwischenwerte für dieses Wort, keine festen Gewichte. Bei einem anderen Wort können sie sich ändern. Die Parameter bleiben dagegen gleich, solange wir sie nicht ändern.
Unsere zusätzliche Auswertungsregel lautet: Bei y >= 1 lautet die Klasse „ja“, sonst „nein“. Der Wert 2 ist keine Wahrscheinlichkeit. Wir haben bewusst einen einfachen Zahlenwert und einen Grenzwert gewählt. Wie ein einzelnes Neuron seine Eingaben verarbeitet, rechnen wir im nächsten Teil genauer durch.
Das Netz selbst ausführen
Wir verwenden den Projektordner und die Python-Umgebung aus Teil 1. Öffne ein Terminal in der Linux-VM und wechsle in den Ordner:
cd ~/eigene-kiWenn du die automatische Aktivierung aus Teil 1 eingerichtet hast, sollte die Umgebung nun geladen werden. Andernfalls aktiviere sie mit source .venv/bin/activate. Zusätzliche Python-Pakete sind für dieses Beispiel nicht erforderlich. Die Datei regel.py aus Teil 1 bleibt erhalten.
Erstelle im Projektordner eine neue Datei netz.py mit folgendem Inhalt:
def relu(wert):
    return max(0.0, wert)


def vorhersage(text):
    x1 = int(len(text) >= 5)
    x2 = int(text.startswith("K"))

    # Pro Zeile: Gewichte von x1 und x2 für ein verborgenes Neuron.
    gewichte_verborgen = ((1.0, 1.0), (1.0, 1.0))
    bias_verborgen = (-1.0, 0.0)
    gewichte_ausgabe = (1.0, 0.5)
    bias_ausgabe = 0.0

    h1 = relu(x1 * gewichte_verborgen[0][0] + x2 * gewichte_verborgen[0][1] + bias_verborgen[0])
    h2 = relu(x1 * gewichte_verborgen[1][0] + x2 * gewichte_verborgen[1][1] + bias_verborgen[1])
    y = relu(h1 * gewichte_ausgabe[0] + h2 * gewichte_ausgabe[1] + bias_ausgabe)
    klasse = "ja" if y >= 1.0 else "nein"
    return (x1, x2), (h1, h2), y, klasse


for wort in ("Katze", "Klee", "Elefant", "Maus"):
    eingabe, verborgen, ausgabe, klasse = vorhersage(wort)
    print(f"{wort}: x={eingabe} h={verborgen} y={ausgabe:.1f} Klasse={klasse}")
Starte das Programm:
python netz.pyFür die festgelegten Werte sollte die Ausgabe so aussehen:
Katze: x=(1, 1) h=(1.0, 2.0) y=2.0 Klasse=ja
Klee: x=(0, 1) h=(0.0, 1.0) y=0.5 Klasse=nein
Elefant: x=(1, 0) h=(0.0, 1.0) y=0.5 Klasse=nein
Maus: x=(0, 0) h=(0.0, 0.0) y=0.0 Klasse=nein
Die zwei Zahlen in x entsprechen den zwei Eingabeknoten, die zwei Zahlen in h den verborgenen Neuronen. y ist ein einzelner Ausgabewert. Die Ausgabe für „Katze“ lässt sich direkt mit der Rechnung oben vergleichen.
Was verändert eine andere Eingabe?
Ergänze "Karte" und "Kuh" in der Wortliste und starte das Programm erneut. Sage zuerst voraus, welche Merkmale entstehen. "Karte" ergibt (1, 1) und damit dieselben Zwischenwerte wie „Katze“. "Kuh" ergibt (0, 1) und dieselben Werte wie „Klee“. Das Netz kann Wörter mit denselben beiden Merkmalen hier nicht unterscheiden. Es sieht weder die Buchstabenfolge noch die Bedeutung des Wortes.
Ändere als zweite Übung den Bias von h1 in bias_verborgen von -1.0 auf -2.0. Starte das Programm erneut und vergleiche die Zwischenwerte und Klassen mit der ersten Ausgabe. Danach den ursprünglichen Wert wiederherstellen. Die Gewichte und Bias-Werte werden beim Ausführen nicht automatisch angepasst. Wir haben sie von Hand gewählt, damit das Beispiel die vier Merkmalskombinationen wie gewünscht einteilt. Das ist noch kein Training und kein Nachweis, dass das Netz über diese künstliche Aufgabe hinaus etwas verstanden hat.
Falls python oder netz.py nicht gefunden wird, prüfe mit pwd und ls, ob du in ~/eigene-ki bist und die Datei gespeichert hast. Bei einem SyntaxError helfen die angegebene Zeilennummer, gerade Anführungszeichen und die Einrückungen im Code. Falls ein anderes Ergebnis erscheint, vergleiche Gewichte und Bias-Werte mit der Tabelle und mache Änderungen aus der Übung rückgängig.
Wie geht es weiter?
Im nächsten Teil nehmen wir eines der künstlichen Neuronen auseinander: Was genau bewirken Gewicht, Bias und Aktivierungsfunktion? Wir rechnen an denselben Werten weiter. Später machen wir das Netz trainierbar. Erst danach schlagen wir die Brücke zum Sprachmodell.