Eine Eingabe auf dem Weg durch das Netz
Im dritten Teil haben wir ein einzelnes Neuron berechnet und als Funktion neuron() umgesetzt. Nun verfolgen wir eine Eingabe durch das vollständige Netz: vom Wort über zwei Merkmale und zwei verborgene Neuronen bis zum Ausgabewert und zur Klasse.
Der Ablauf heißt Vorwärtsdurchlauf oder Forward Pass. Wir verwenden dieselben Gewichte und Bias-Werte wie in den vorherigen Teilen. Dabei wird nichts gelernt oder angepasst. Wir beobachten zunächst nur, was mit einer Eingabe geschieht.
Praxistest: Der Artikel, die Ablaufanzeige und die Übungen wurden in einer Linux-Mint-VM nachvollzogen und bestätigt.
Unser Netz und seine Eingabe
Zur Erinnerung: Unser Netz verarbeitet nicht direkt Buchstaben. Zwei feste Regeln wandeln ein Wort in Merkmale um:
x1 = 1, wenn es mindestens fünf Zeichen hat, sonst0.x2 = 1, wenn es mit einem großenKbeginnt, sonst0.
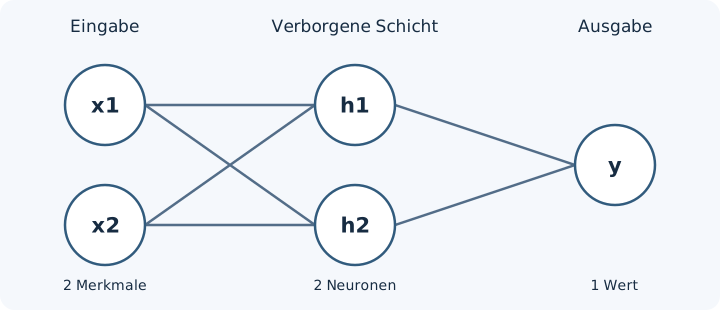
Wir verwenden wieder „Katze“. Daraus entsteht das Zahlenpaar (1, 1). Die zwei Eingaben gehen jeweils an beide verborgenen Neuronen h1 und h2. Deren Ausgaben bilden gemeinsam die Eingabe für das Ausgabeneuron y.
Der Vorwärtsdurchlauf für „Katze“ lässt sich mit denselben Werten auch als Ablauf darstellen:
Die beiden verborgenen Neuronen erhalten dieselbe Eingabe und berechnen ihre Werte unabhängig voneinander.
- Text und Merkmale
„Katze“ → x = (1, 1): Länge mindestens 5 und Beginn mit K
- Verborgene Schicht
h1 = ReLU(1 × 1 + 1 × 1 − 1) = 1; h2 = ReLU(1 × 1 + 1 × 1 + 0) = 2
- Ausgabeneuron
y = ReLU(1 × h1 + 0,5 × h2 + 0) = 2
- Auswertung
y = 2 ist mindestens 1: Klasse „ja“
Die Darstellung fasst die Verarbeitung zusammen. Sie bedeutet nicht, dass h1 seine Ausgabe an h2 weitergibt. Beide erhalten die ursprünglichen Merkmale. Erst das Ausgabeneuron kombiniert ihre Ergebnisse.
Die erste Schicht von Hand berechnen
h1 und h2 erhalten also dieselbe Eingabe (1, 1), besitzen aber eigene Parameter:
| Neuron | Gewicht für x1 | Gewicht für x2 | Bias |
|---|---|---|---|
| h1 | 1 | 1 | -1 |
| h2 | 1 | 1 | 0 |
Für jedes Neuron multiplizieren wir die Eingaben mit den zugehörigen Gewichten, addieren die Beiträge und den Bias. Auf diese Zwischensumme z wenden wir ReLU an. ReLU ersetzt negative Werte durch 0 und lässt nichtnegative Werte stehen.
h1: z = 1 × 1 + 1 × 1 - 1 = 1     ReLU(1) = 1
h2: z = 1 × 1 + 1 × 1 + 0 = 2     ReLU(2) = 2
Die verborgene Schicht liefert für diese Eingabe also das Zahlenpaar (1, 2). Der Unterschied zwischen h1 und h2 entsteht hier durch den unterschiedlichen Bias. Beide Ergebnisse werden für den nächsten Schritt gebraucht.
Von der verborgenen Schicht zur Ausgabe
Das Ausgabeneuron bekommt h1 = 1 und h2 = 2. Seine Gewichte sind 1 für h1 und 0,5 für h2, sein Bias ist 0. Es verwendet ebenfalls ReLU:
Beiträge: 1 × 1 = 1 und 2 × 0,5 = 1
z = 1 + 1 + 0 = 2
y = ReLU(2) = 2
Das ist die Netzausgabe. Erst danach wendet unser Programm eine zusätzliche Entscheidungsregel an: Bei y >= 1 heißt die Klasse „ja“, ansonsten „nein“. Für „Katze“ erhalten wir 2 >= 1, also „ja“.
y = 2 ist weder eine Wahrscheinlichkeit noch eine Prozentangabe. Es ist der von unserem Beispielnetz berechnete Wert. Andere Modelle können Ausgabefunktionen verwenden, deren Werte anders interpretiert werden. Selbst dann muss geprüft werden, ob die ausgegebenen Werte gut zu tatsächlichen Häufigkeiten passen.
Was bedeutet die Größe einer Schicht?
Für ein einzelnes Wort ist die Eingabe unseres Netzes ein Tupel mit zwei Zahlen. Die verborgene Schicht liefert ebenfalls zwei Zahlen. Das Ausgabeneuron liefert eine Zahl:
Merkmale:             (x1, x2)    2 Werte
Verborgene Schicht:   (h1, h2)    2 Werte
Ausgabe:              y           1 Wert
Die Werte sind keine Gewichte. Die Gewichte bestimmen zusammen mit den Bias-Werten, wie aus einer Eingabe eine Ausgabe wird. Beim nächsten Wort bleiben unsere Parameter unverändert, während die Zwischenwerte neu berechnet werden. Verarbeiten wir mehrere Wörter, wiederholen wir diesen Ablauf hier einzeln für jedes Wort.
Zum Vergleich „Klee“: Die Merkmale sind (0, 1). Damit erhält h1 die Summe 0 und Ausgabe 0. h2 erhält Summe und Ausgabe 1. Das Ausgabeneuron berechnet ReLU(0 × 1 + 1 × 0,5) = 0,5. Weil 0,5 < 1, ergibt sich „nein“.
Das Programm um eine Ablaufanzeige ergänzen
Wir verwenden die Dateien neuron.py und netz.py aus Teil 3. Die Funktion neuron() gibt bereits die Beiträge, die Summe mit Bias und die Ausgabe zurück. Bisher hat netz.py nur die Ausgabe übernommen. Jetzt zeigen wir alle drei Werte an.
Öffne ein Terminal in der Linux-VM und gehe zum Projektordner:
cd ~/eigene-kiWenn die automatische Aktivierung eingerichtet ist, wird die Python-Umgebung geladen. Andernfalls aktiviere sie mit source .venv/bin/activate. Zusätzliche Pakete brauchen wir nicht. neuron.py bleibt unverändert.
Öffne netz.py und ersetze den Inhalt durch den folgenden Code:
import sys

from neuron import neuron


def vorhersage(text, anzeigen=False):
    x1 = int(len(text) >= 5)
    x2 = int(text.startswith("K"))

    gewichte_verborgen = ((1.0, 1.0), (1.0, 1.0))
    bias_verborgen = (-1.0, 0.0)
    gewichte_ausgabe = (1.0, 0.5)
    bias_ausgabe = 0.0

    beitraege1, z1, h1 = neuron((x1, x2), gewichte_verborgen[0], bias_verborgen[0])
    beitraege2, z2, h2 = neuron((x1, x2), gewichte_verborgen[1], bias_verborgen[1])
    beitraege_y, z_y, y = neuron((h1, h2), gewichte_ausgabe, bias_ausgabe)
    klasse = "ja" if y >= 1.0 else "nein"

    if anzeigen:
        print(f"Wort: {text}")
        print(f"Merkmale: x=({x1}, {x2})")
        print(f"h1: Beiträge={beitraege1}, Bias={bias_verborgen[0]}, z={z1}, Ausgabe={h1}")
        print(f"h2: Beiträge={beitraege2}, Bias={bias_verborgen[1]}, z={z2}, Ausgabe={h2}")
        print(f"y:  Beiträge={beitraege_y}, Bias={bias_ausgabe}, z={z_y}, Ausgabe={y}")
        print(f"Klasse: {klasse}")

    return (x1, x2), (h1, h2), y, klasse


if __name__ == "__main__":
    woerter = sys.argv[1:] or ["Katze", "Klee", "Elefant", "Maus"]
    for wort in woerter:
        vorhersage(wort, anzeigen=True)
        print()
Die Funktion heißt weiterhin vorhersage() und gibt wie zuvor Eingabe, verborgene Werte, Ausgabe und Klasse zurück. Der optionale Parameter anzeigen schaltet die detaillierte Ausgabe ein. Für einen normalen Aufruf ohne diesen Parameter wird nichts zusätzlich ausgegeben. if __name__ == "__main__": sorgt dafür, dass die Wortliste nur beim direkten Starten der Datei verarbeitet wird.
Teste zunächst ein einzelnes Wort:
python netz.py KatzeErwartete Ausgabe:
Wort: Katze
Merkmale: x=(1, 1)
h1: Beiträge=[1.0, 1.0], Bias=-1.0, z=1.0, Ausgabe=1.0
h2: Beiträge=[1.0, 1.0], Bias=0.0, z=2.0, Ausgabe=2.0
y:  Beiträge=[1.0, 1.0], Bias=0.0, z=2.0, Ausgabe=2.0
Klasse: ja
Die Listen bei Beiträge enthalten die gewichteten Eingaben des jeweiligen Neurons. Vergleiche z und Ausgabe mit der Handrechnung. Ohne zusätzliches Wort verarbeitet python netz.py weiterhin die vier bekannten Beispiele. Du kannst auch mehrere Wörter angeben:
python netz.py Klee ElefantBei Klee und Elefant sollten unterschiedliche Merkmale, aber jeweils h=(0, 1), y=0.5 und die Klasse „nein“ entstehen. Diese Ergebnisse lassen sich aus den einzelnen Zeilen der Ablaufanzeige ablesen.
Selbst ausprobieren
- Eingabe verfolgen: Starte
python netz.py Maus. Berechne vorab die beiden Merkmale und erwarte für beide verborgenen Neuronen sowie das Ausgabeneuron jeweils0. - Andere Eingaben vergleichen: Starte
python netz.py Karte Kuh. „Karte“ hat dieselben Merkmale wie „Katze“, „Kuh“ dieselben wie „Klee“. Prüfe, ob die Zwischenwerte entsprechend übereinstimmen. - Einen Parameter verändern: Ändere in
netz.pydas zweite Ausgabegewicht von0.5auf0.0. Für „Katze“ wird ausy=2.0nuny=1.0, die Klasse bleibt „ja“. Stelle anschließend0.5wieder her und prüfe die ursprüngliche Ausgabe erneut.
Wir verändern das Gewicht in der Übung selbst. Das ist weiterhin kein Training. Die Parameter bleiben beim normalen Vorwärtsdurchlauf unverändert, auch wenn das Netz mehrere Wörter verarbeitet.
Wenn ModuleNotFoundError: No module named 'neuron' erscheint, prüfe mit pwd und ls, ob netz.py und neuron.py im selben Projektordner liegen. Bei ValueError prüfe die Anzahl von Eingaben und Gewichten. Falls die Ausgaben von den Beispielen abweichen, vergleiche die Parameter und setze Änderungen aus den Übungen zurück.
Wie geht es weiter?
Wir können jetzt für jede Eingabe die Zwischenwerte bis zur Ausgabe verfolgen. Im nächsten Teil kommt der Schritt hinzu, der bisher fehlt: Wir vergleichen Vorhersagen mit gewünschten Ergebnissen und untersuchen, wie ein Lernverfahren die Parameter verändern kann. Der Vorwärtsdurchlauf bleibt dabei ein Bestandteil des Trainings.